
 ormeilu
Скилл для ИИ-агентов и CLI на TypeScript/Bun: находит и убирает ИИ-стиль в русских текстах
Скилл для ИИ-агентов и CLI на TypeScript/Bun: находит и убирает ИИ-стиль в русских текстах (канцелярит, кальки, штампы), проверяет сохранность правки и оценивает текст по фрагментам в духе «Антиплагиата» с калибровкой по вашим отчётам. Русская адаптация avoid-ai-writing.
·
avoid-ai-writing-russian
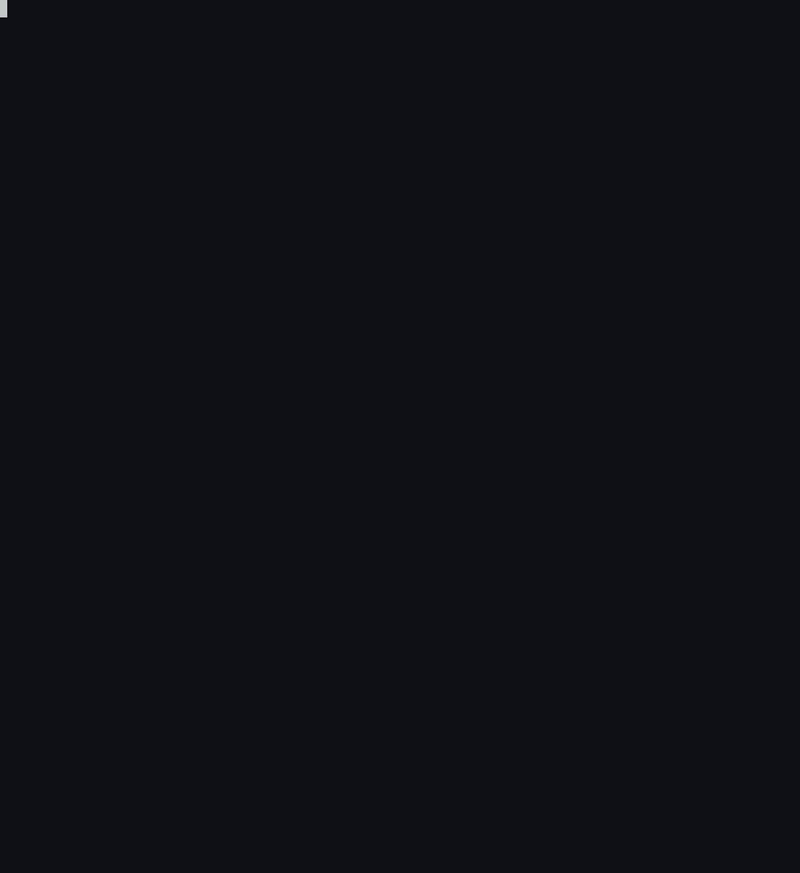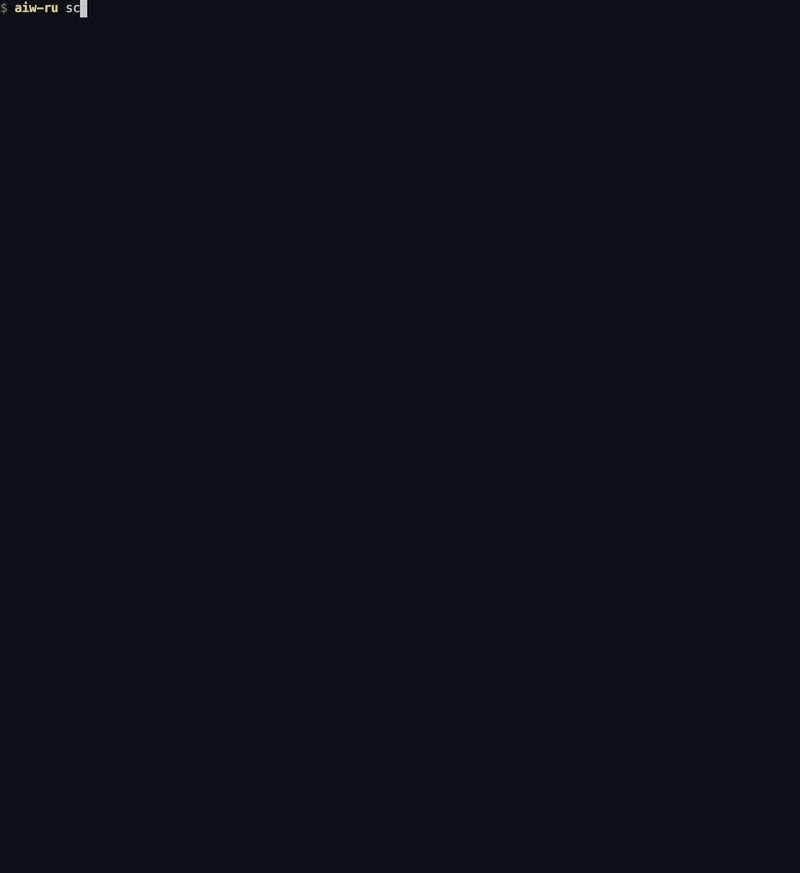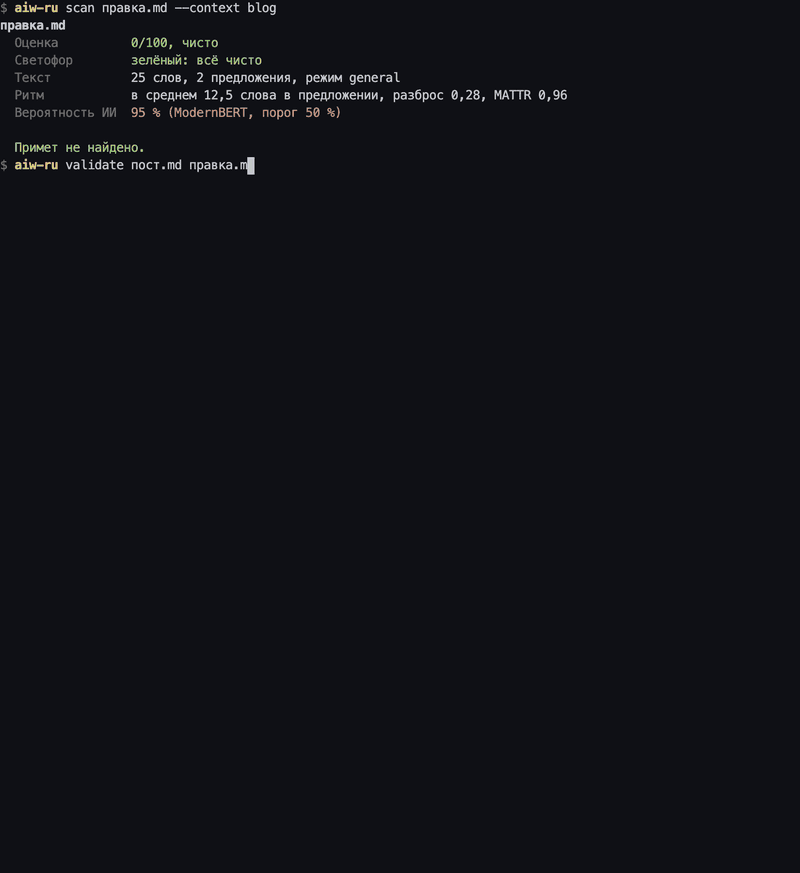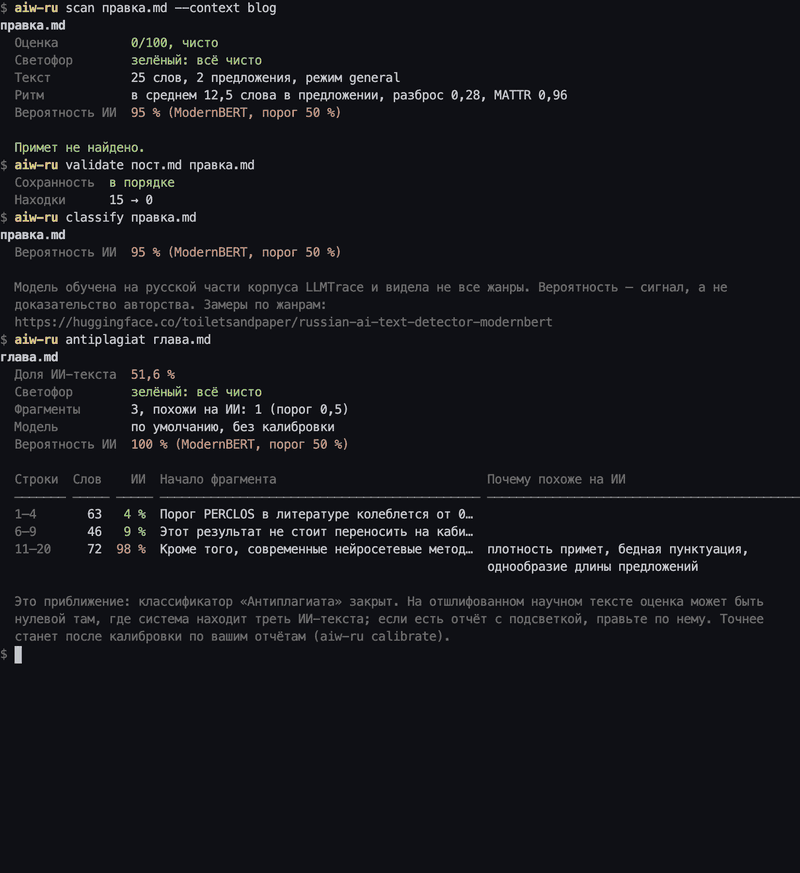
Скилл для ИИ-агентов (Claude Code, Codex, Cursor и других), который находит и убирает из русских текстов приметы машинной генерации: канцелярит, кальки с английского, «не просто X, а Y», тире-связки, одинаковый ритм предложений. К нему прилагается детектор на Python (aiw-ru) и под-скилл antiplagiat для текстов, которые пойдут в «Антиплагиат» или «Думейт»: он правит абзацы, подсвеченные в отчёте системы, и оценивает текст по фрагментам в духе её модуля ИИ-детекции.
Это русская адаптация avoid-ai-writing Конора Бронсдона. Устройство скилла взято оттуда, каталог примет переписан под русский язык, детектор написан заново. Подробности в разделе «Благодарности».
Содержание
- Зачем
- Пример
- Установка
- Как пользоваться
- Под-скилл antiplagiat
- Детектор
- Что ловит каталог
- Ограничения
- Разработка
- Выпуски
- Как сослаться
- Благодарности
- Лицензия
Зачем
Английские «очеловечиватели» на русском почти бесполезны. Они ищут delve и tapestry, а русский текст модели выдаёт себя другим: «является», «осуществляется», «в рамках данной работы», «играет ключевую роль», «на ежедневной основе», цепочками вроде «обеспечение повышения эффективности проведения мониторинга» и прямыми кавычками там, где нужны «ёлочки». Половина этого — канцелярит, которым люди писали задолго до нейросетей; модели выучили его из госдокументов и рефератов и воспроизводят с удвоенной частотой. Другая половина — синтаксис, протащенный из английского черновика, на котором модель «думала».
Скилл помогает двум группам:
- тем, кто хочет меньше ИИ-стиля в своих текстах: статьях, документации, постах, письмах;
- тем, чей текст пойдёт на проверку в «Антиплагиат» или «Думейт» и кому не нужны ложные срабатывания модуля ИИ-детекции на собственном тексте.
Пример
До (типичный ответ модели на просьбу написать абзац про ИИ в медицине):
В современном мире искусственный интеллект играет ключевую роль в развитии здравоохранения. Данная технология открывает новые возможности для диагностики и лечения заболеваний. Стоит отметить, что внедрение ИИ осуществляется в рамках комплексного подхода к цифровой трансформации отрасли. Кроме того, нейросетевые модели позволяют значительно повысить точность диагностики. Исследования показывают, что такие системы обеспечивают высокую эффективность при анализе медицинских изображений.
Детектор: 98/100, «сильный ИИ-стиль». В пяти предложениях он нашёл размытую ссылку на авторитет («Исследования показывают»), пять слов-маркеров, две оценки без чисел, пять случаев канцелярита, шаблонный переход и скопление слов второго уровня.
После правки скиллом:
ИИ в медицине пока применяют в основном для анализа изображений и помощи в диагностике. Насколько такие системы точнее врача, в исходном тексте не сказано. Нужны цифры и ссылка на исследование, иначе утверждение не проверить.
Проверка: один проход. Скилл убрал разбег, штампы и пустые оценки. Число и источник он не выдумал, а пометил как пробел: исходник их не давал. Это правило «никогда не добавляй» из исходного проекта. Для научного текста оно важнее всего остального.
Установка
Claude Code: плагин
claude plugin marketplace add ormeilu/avoid-ai-writing-russian
claude plugin install avoid-ai-writing-russian@avoid-ai-writing-russian
Плагин ставит оба скилла, avoid-ai-writing-russian и antiplagiat, вместе с детектором. Детектору нужен uv.
Kimi Code, pi, Hermes и DeepSeek Harness
Во всех четырёх средах ставится весь репозиторий: скиллы ссылаются друг на друга, а детектор лежит в корне. Манифесты (.kimi-plugin/plugin.json, package.json, plugin.json) указывают на ту же папку skills/.
Kimi Code: внутри сессии kimi выполните команду ниже, подтвердите установку стороннего плагина и перезапустите сессию через /reload. Скиллы появятся как avoid-ai-writing-russian:avoid-ai-writing-russian и avoid-ai-writing-russian:antiplagiat.
/plugins install https://github.com/ormeilu/avoid-ai-writing-russianpi (pi coding agent): пакет ставится из git, скиллы вызываются и как /skill:avoid-ai-writing-russian.
pi install git:github.com/ormeilu/avoid-ai-writing-russianHermes Agent читает корневой plugin.json в формате Agent Plugins v1. Сканер Hermes помечает в репозитории команды uv run из документации и скиллов и без --force установку из стороннего источника не пропускает: посмотрите его отчёт и ставьте, если согласны. Такие плагины ставятся выключенными, поэтому вторая команда включает его. При включении Hermes ставит детектор в своё окружение по pyproject.toml.
hermes plugins install ormeilu/avoid-ai-writing-russian --forcehermes plugins enable avoid-ai-writing-russianDeepSeek Harness (dsh) не ставит скиллы из плагинов: он читает папки ~/.dsh/skills/ и ~/.agents/skills/, только на один уровень вглубь. Клонируйте репозиторий, как в следующем разделе, и сделайте ссылки:
ln -s ~/src/avoid-ai-writing-russian/skills/avoid-ai-writing-russian ~/.dsh/skills/avoid-ai-writing-russianln -s ~/src/avoid-ai-writing-russian/skills/antiplagiat ~/.dsh/skills/antiplagiatПапку ~/.agents/skills/ читают ещё pi и Codex: ссылки там подхватят все три агента сразу.
Claude Code, Codex и другие агенты: папка скилла
Клонируйте репозиторий и скопируйте папки скиллов туда, где агент их ищет. Детектор лежит в корне репозитория, а скиллы зовут его командой uv run --project ../.. aiw-ru …, поэтому удобнее ссылка, а не копия:
git clone https://github.com/ormeilu/avoid-ai-writing-russian.git ~/src/avoid-ai-writing-russianln -s ~/src/avoid-ai-writing-russian/skills/avoid-ai-writing-russian ~/.claude/skills/avoid-ai-writing-russianln -s ~/src/avoid-ai-writing-russian/skills/antiplagiat ~/.claude/skills/antiplagiatДля Codex используйте ~/.codex/skills/ или ~/.agents/skills/, для Cursor — правила проекта. Агентам без поддержки SKILL.md можно передать текст SKILL.md и references/patterns.md как инструкцию.
Детектор
Скиллам нужен uv или aiw-ru в PATH: при первом запуске uv сам поставит Python 3.12 или новее и зависимости детектора (regex, rich, pydantic), а установленный aiw-ru скилл зовёт напрямую. Без обоих скилл работает, но проверки будут только модельными, и он об этом скажет.
Отдельно от скиллов детектор ставится из PyPI:
uv tool install aiw-ruИли запускается без установки: uvx aiw-ru scan статья.md. Подойдёт и pip install aiw-ru. Какая версия стоит, покажет aiw-ru --version.
Только команда, без плагина
Скиллы лежат и в пакете. Если стоит только aiw-ru, их выводит сама команда:
aiw-ru skillaiw-ru skill avoid-ai-writing-russianПервая показывает список скиллов, вторая печатает SKILL.md для агента. Вызовы детектора в нём уже переписаны на aiw-ru …, а каталог примет выводит aiw-ru skill avoid-ai-writing-russian references/patterns.md. Агенту достаточно сказать: «выполни aiw-ru skill avoid-ai-writing-russian и работай по этому скиллу».
Необязательные модели
Кроме правил, у детектора есть несколько моделей, обученных на русской части корпуса LLMTrace. Каждая оценивает вероятность, что текст написала языковая модель:
- ModernBERT: дообученный русский ModernBERT в ONNX, самый точный, читает текст целиком до 8192 токенов, около 140 МБ, работает на CPU без torch (карточка);
- LightGBM на признаках детектора: около 10 МБ, легче и быстрее, но заметно менее точный (карточка);
- трансформер: дообученный русский BERT, около 30 МБ, почти так же точен и в несколько раз быстрее ModernBERT, для слабой машины; ставится только по имени,
aiw-ru models install transformer(карточка); - mini-frida: по ROC AUC между ModernBERT и трансформером, около 130 МБ и в 3 раза медленнее трансформера, а при пороге 50 % чаще принимает людей за ИИ; ставится только по имени,
aiw-ru models install mini-frida(карточка).
Вместе со скиллами модели не ставятся, агент предложит их сам и поставит, только если вы согласитесь. Вручную:
uv tool install "aiw-ru[ml]"aiw-ru models installБез имени ставятся ModernBERT и LightGBM, aiw-ru models install lightgbm ставит только лёгкую, а aiw-ru models install transformer lightgbm — лёгкий набор для слабой машины. Сравнить модели до скачивания можно командой aiw-ru models info: качество на корпусе, скорость, память и размер каждой; aiw-ru models info ИМЯ показывает одну модель подробно. Пакеты extra ml занимают около 200 МБ. Файлы моделей скачиваются в общий кэш ~/.cache/huggingface. Если стоят несколько, вероятность в scan, antiplagiat и classify даёт первая из установленных в порядке ModernBERT, трансформер, mini-frida, LightGBM: по доле людей, которых модель принимает за ИИ (3,4 %, 7,2 %, 9,5 % и 16,5 % на test). Другую модель выбирает --model. В карточках на Hugging Face результаты на LLMTrace по жанрам, длине текста и моделям-генераторам.
На macOS LightGBM нужна библиотека libomp: brew install libomp. Без неё aiw-ru models так и скажет. Для Mac на Intel у onnxruntime нет сборок, там работает только LightGBM.
Как пользоваться классификацией, печатает aiw-ru models guide: какую модель взять под свою машину, как читать вероятность и итог по фрагментам длинного текста, как перепроверить отмеченные строки. То же руководство читает агент в скилле.
Модели работают через onnxruntime, а не PyTorch: колесо onnxruntime весит 24 МБ, PyTorch на Linux тянет 555 МБ и ещё 1,25 ГБ библиотек CUDA. Для старых ноутбуков и песочниц агентов без видеокарты это решает. Замеры скорости и памяти и что сделано, чтобы ONNX не отставал на длинном окне, — в docs/runtime.md.
Как пользоваться
Обычной фразой агенту:
- «убери ИИ-стиль из этого абзаца»;
- «просканируй
glava2.md, ничего не правь»; - «почисти
README.mdна месте, профиль docs»; - «перепиши прямее для Telegram-канала»;
- «подготовь главу к антиплагиату» (включается под-скилл).
Режимы: rewrite (по умолчанию, вернуть исправленный текст), detect (только найти), edit (править файл на месте точечными правками).
Профили контекста меняют строгость правил:
| Профиль | Для чего |
|---|---|
vak | диссертация, автореферат, статьи ВАК/РИНЦ, отчёты по НИР |
docs | документация, README, инструкции |
blog | статьи, эссе, Хабр (по умолчанию) |
telegram | посты в каналах и соцсетях |
business-email | деловые письма, КП, письма инвесторам |
chat | переписка и комментарии: только грубые приметы |
Профили голоса (casual, professional, technical, warm, blunt) задают звучание правки. Голос проявляет то, что уже есть в тексте, но не придумывает автору мнений и опыта.
Скилл сохраняет цитаты, код, формулы, таблицы, ссылки на литературу, список литературы и числа. Правку он заканчивает отчётом: сколько было проходов, какие проверки запускались, какие находки оставлены и почему.
Под-скилл antiplagiat
Включается, когда текст идёт на проверку в «Антиплагиат» или «Думейт». Порядок работы:
- Отчёт системы. Агент первым делом просит отчёт, где система подсветила ИИ-текст: он прямо говорит, какие абзацы править. У «Думейта» это тепловая карта полного отчёта: в процент входят только красные фрагменты, оранжевые и жёлтые лишь подсвечены. Агент выпишет фрагменты из PDF или скриншотов, а если у него есть браузер, заберёт тепловую карту со страницы отчёта, пока вы сами вошли в аккаунт.
- Замер: оценка доли «ИИ-текста» по фрагментам и список рискованных абзацев с причинами. Если отчёта нет, тепловой картой служат фрагменты самого детектора: красные выше порога, жёлтые в пределах 0,1 под ним. Абзацы выбирает ещё и слепой судья: свежий агент без контекста редактора оценивает пронумерованные фрагменты, два-три прогона усредняются.
- Чистка технических артефактов: невидимые символы и латинские буквы внутри русских слов. Из-за них система помечает документ как подозрительный, и это хуже любого процента.
- Правка подсвеченных фрагментов по правилам основного скилла: ритм, каркас абзаца (пояснения через двоеточие, мораль в конце, «во-первых… в-третьих»), пунктуация. Классификаторы смотрят на структуру сильнее, чем на слова. Без отчёта агент правит по целям
antiplagiat --explain: какой признак тянет абзац вверх и до каких замеров его довести. - Цикл «замер, правка,
validateпротив исходника, замер» без лимита проходов: он идёт, пока доля ИИ-текста не дойдёт до нуля или проход не перестанет её снижать. Потом свежий агент сверяет смысл, оговорки и термины. Итог показывает только повторная проверка в самой системе, и её отчёт агент просит принести для калибровки. - Калибровка детектора по вашим отчётам, у каждой системы своя. Всё считается локально.
На обзорной статье в 2600 слов правка 27 красных абзацев снизила долю ИИ в «Думейте» с 38 до 10 %, оригинальность не изменилась. На реферате два прохода по красным абзацам дали 42,72 → 9,38 → 0 %. Неразрывные пробелы процент не двигали ни там, ни там: снижала его правка каждого красного абзаца, даже лёгкая. Это два документа одного автора и одна версия детектора; цифры и ограничения — в docs/domate.md.
Скилл работает с вашим собственным текстом. Заимствования он помогает оформить как цитирования (кавычки и ссылка на источник), чтобы система засчитала их законно. Маскировать чужой текст перефразированием, синонимайзером или подменой символов он не будет: это выдача чужой работы за свою, а не спор с плохим детектором.
Детектор
aiw-ru scan статья.md --context vakaiw-ru antiplagiat глава1.mdaiw-ru validate исходник.md правка.mdaiw-ru validate исходник.md правка.md --marked heat.jsonaiw-ru calibrate --doc глава1.md --marked глава1-подсвечено.txtaiw-ru calibrate --doc глава2.md --share 34aiw-ru calibrate --system domate --doc статья.md --marked heat.jsonaiw-ru judge статья.md > задание.txtaiw-ru judge score статья.md --answers r1.txt --answers r2.txt --marked heat.jsonaiw-ru classify статья.mdscan печатает оценку 0–100, статистику ритма и таблицу находок: уровень P0–P2, строка и столбец, примета, фрагмент и подсказка. Таблица подстраивается под ширину терминала, длинный текст переносится внутри ячейки. Цвет включается только в терминале; NO_COLOR=1 его выключает, FORCE_COLOR=1 включает принудительно. Параметр --json даёт машиночитаемый вывод, --jsonl проверяет пачку документов (по документу в строке, {"text": "…"}, ответ тоже по строке на документ), --fail-above N возвращает код 1, если оценка выше N (удобно в CI для документации). Под таблицей и в поле catalog JSON перечислены файлы каталога скилла с разделами, где описаны условия и исключения найденных примет: агенту хватает открыть их, а не весь каталог.
Строка «Светофор» (в JSON поле light, оно есть и у antiplagiat) говорит, что делать с символами до правки стиля. Зелёный: всё чисто. Жёлтый, «ИИ или типография?»: в прозе есть редкие типографские символы (неразрывные и узкие пробелы, шпации, неразрывный дефис, знак минуса, стрелки) или мягкие переносы. Их ставят и рассуждающие модели OpenAI, и вёрстка, поэтому агент спрашивает вас, убрать их или оставить. Красный, «почти наверняка ИИ или маскировка»: разметка ссылок из чата, utm_source=chatgpt.com, невидимые символы, подмена букв; их агент удаляет.
Статью в Word сначала переведите в Markdown: pandoc статья.docx -t gfm --wrap=none -o статья.md. Без --wrap=none pandoc режет абзацы по ширине строки. Номера строк в находках относятся к статья.md, а не к docx. Список литературы, ключевые слова, английскую аннотацию, сведения об авторах, строки «УДК» и «Для цитирования» детектор считает служебными частями статьи: правила стиля, antiplagiat и модели их не оценивают. Список литературы находится по заголовку («Список литературы», «Библиографический список», «References») или по трём записям подряд.
antiplagiat делит текст на фрагменты (абзацы, короткие склеиваются), описывает каждый семью признаками и переводит их в вероятность логистической моделью. Признаки: плотность примет, однообразие длины предложений, типичная для моделей длина предложения, канцелярит, бедная пунктуация, однообразные начала предложений, бедный словарь. Доля ИИ-текста считается по знакам, как в отчёте системы.
Каждый фрагмент получает цвет: красный от порога и выше, жёлтый в пределах 0,1 под порогом, остальные зелёные (поле zone в JSON). --explain разбирает красные и жёлтые фрагменты: вклад каждого признака в логит, замер, от которого он зависит, и цель, при которой фрагмент уходит в зелёную зону.
Строка 5: 52 %, красный, зелёная зона ниже 34 %
  Цель  средняя длина не больше 10 или не меньше 28 слов; cv длин от 0,57
  Признак                        Вклад  Сейчас                         Хватит одного
  типичная длина предложения     +0,57  средняя длина 15,3 слова       нет
  однообразие длины предложений  +0,46  cv длин 0,46 (8, 22, 16 слов)  нет
Строка «Цель» делит нужное снижение между признаками пропорционально тому, сколько каждый может снять. В JSON разбор лежит в поле explain фрагмента: замеры (measures: длины предложений, повторы начал, MATTR, приметы), вклады (contributions) и план (plan). Если калибровка ставит ровную научную прозу у порога, то есть абзац со средней длиной предложения около 19 слов и без других признаков получает вероятность в жёлтой зоне или выше, antiplagiat и calibrate об этом предупреждают (поле typicalProse в JSON).
validate сравнивает исходник и правку. Код, формулы, URL, числа, ссылки [12] и [@key], таблицы, цитаты, список литературы и другие служебные части статьи и структура заголовков должны остаться на месте, а находок должно стать не больше. Разрешённые правки нарушением не считаются: «ёлочки» вместо прямых кавычек, запятая вместо десятичной точки, удалённый utm_source=chatgpt.com.
Ещё validate сверяет факты (идея из humanizer-ru). Правка не должна снимать оговорки вроде «обычно», «примерно», «от 5000», «по-видимому» и добавлять имена, названия, аббревиатуры, числа словами и месяцы, которых нет в исходнике. Свести стопку оговорок к одной можно: «потенциально может» → «может» нарушением не считается. Снятое одиночное «может», новые слова-претензии («впервые», «всегда», «единственный») и мелкие числа словами («один», «оба») идут предупреждениями, в JSON это поле warnings. Код выхода они не меняют: без морфологии такие места не отличить от законной правки, их нужно сверить глазами.
С --marked (тепловая карта «Думейта» или файл с подсвеченными фрагментами) validate ещё и называет абзацы под красной подсветкой, которые остались прежними: такой абзац при повторной проверке останется красным. Снятые неразрывные пробелы и замена дефисов правкой не считаются, заголовки, таблицы, рисунки и абзацы короче 15 слов не проверяются.
calibrate дообучает модель antiplagiat на ваших отчётах. Лучше всего работает разметка фрагментов: текстовый файл с кусками, которые система подсветила как сгенерированные, по одному на абзац через пустую строку. Собирать его руками не обязательно: агент выпишет фрагменты сам из PDF отчёта или скриншотов. Если под рукой только итоговая цифра, передайте её через --share: так подстраивается общая строгость модели, но не веса признаков. Образцы накапливаются в .aiw-ru.json, и с каждым отчётом оценка точнее отражает поведение системы на ваших текстах. Отчёты, где система ничего не пометила, тоже пригодятся: это примеры человеческого текста. В файле калибровки только модель и числовые признаки фрагментов, самого текста там нет. В общий репозиторий его всё равно не коммитьте: antiplagiat читает .aiw-ru.json из текущей папки, и ваша калибровка исказит оценку соавторам (в этом репозитории файл уже в .gitignore). Текст есть в файлах с фрагментами из отчётов, их держите вне публичных репозиториев.
--system domate у antiplagiat и calibrate переключает калибровку на «Думейт». Калибровки систем лежат в одном .aiw-ru.json и не мешают друг другу: прежние поля файла остаются за «Антиплагиатом», старые версии aiw-ru читают его как раньше. --marked принимает и тепловую карту «Думейта» в JSON (скрипт для страницы отчёта есть в skills/antiplagiat/references/domate.md): из неё берутся только красные фрагменты. Куски из отчёта сопоставляются с абзацами по первым и последним словам. Абзац считается подсвеченным, если куски покрывают больше половины его слов или какой-то кусок целиком лежит внутри него, поэтому подсветка через несколько абзацев размечает каждый из них.
judge печатает задание для слепого судьи: инструкцию со шкалой none/low/medium/high и фрагменты [P1]…[Pn], нарезанные так же, как в antiplagiat. Задание отдают свежему агенту без другого контекста. judge score сводит ответы нескольких прогонов: средний уровень фрагментов, долю слов со средним medium и выше, совпадение прогонов, а с --marked — ROC AUC судьи и детектора против подсветки отчёта. На статье из docs/domate.md судья дал 0,82 по среднему трёх прогонов, детектор — 0,40. Процент системы судья не предсказывает, правила работы с ним — в references/judge.md.
skill печатает скиллы для агента, у которого нет плагина: без аргументов список, с именем SKILL.md, с именем и путём файл скилла (references/vocabulary.md).
classify отвечает вероятностью от необязательной модели (--model выбирает какой; models info сравнивает их до скачивания). Без установленной модели команда подскажет, как её поставить. Если модель есть, scan и antiplagiat показывают эту вероятность рядом со своей оценкой, а в JSON она лежит в поле classifier вместе с порогом. Вероятность, которая ближе 15 пунктов к порогу, помечена «близко к порогу» (nearThreshold в JSON): модель не уверена. classify --all показывает вероятности всех установленных моделей рядом и пишет, расходятся ли они. Вероятность модели — такой же сигнал, как находки правил: модели уверенно ошибаются на коротких текстах и в жанрах, которых мало в корпусе. Скилл сверяет её с находками и не правит текст ради цифры.
Модели обучены только на русском тексте, и на английском ModernBERT почти всегда уверенно говорит «ИИ». Поэтому YAML-шапку, блоки кода, служебные части статьи и абзацы не на русском им не показывают; строки вырезанных абзацев названы в выводе («Не на русском»), в JSON это notRussianLines. Текст или фрагмент classify, где кириллицы меньше половины букв, модель не оценивает: вероятности у него нет, в JSON language: "other" и skipped: true, а в итог фрагментов он не входит.
Трансформер и mini-frida читают одно окно в 512 токенов, это 300–350 слов от начала текста. ModernBERT читает до 8192 токенов, 4–5 тысяч слов: статью или главу диплома целиком. Если текст длиннее окна, scan, antiplagiat и classify пишут, что прочитала модель: «Прочитано: 351 слово из 4598, строка 1 из 56: окно модели 512 токенов», в JSON это поле read. Где в тексте ИИ, показывает classify: режет текст на фрагменты по 512 токенов по границам предложений (у ModernBERT тоже: на окне в 8192 токена ИИ-вставка тонет в человеческом тексте), соседние заходят друг на друга на четверть фрагмента, и показывает вероятность каждого фрагмента с номерами строк и итог «выше порога 2 фрагмента из 17: строки 26–28». В одно число фрагменты не усредняются: на длинных текстах LLMTrace среднее по окнам не точнее начала, а в документе, где часть написал человек и часть ИИ, среднее прячет ИИ-кусок. На M1 фрагмент занимает около 25 мс у трансформера, 70 мс у ModernBERT и 75 мс у mini-frida, чтение текста целиком у ModernBERT — до 3 секунд на 8192 токенах; текст в 40 000 знаков — около 20 фрагментов и 1–5 секунд. Замер на длинных документах из LLMTrace (docs/long-documents.md): ИИ-вставку фрагменты находят в 88–92 % документов против 13–34 % по началу, но и в целиком человеческом тексте на 20 000 знаков хоть один фрагмент выше порога бывает в 22–37 % документов. Поэтому один отмеченный фрагмент — слабый признак, два и больше — сильнее. Если проверка займёт больше 5 секунд, classify сразу пишет в stderr, сколько ждать. --max-fragments N проверяет только первые N фрагментов, --no-fragments оставляет одну вероятность по началу.
Из Python:
from aiw_ru import analyze

result = analyze(text, "academic")
print(result.score, len(result.issues))
Результаты — модели pydantic: result.to_dict() даёт тот же JSON, что и aiw-ru scan --json, без поля catalog.
Что ловит каталог
Полный каталог лежит в skills/avoid-ai-writing-russian/references/, по файлу на тему. Агент не читает его целиком: он ищет кандидатов по краткому каталогу в SKILL.md и открывает файл темы, только когда правит находку из неё. Коротко:
| Группа | Примеры |
|---|---|
| Следы чат-бота | «Надеюсь, это поможет», «Отличный вопрос!», «как языковая модель» |
| Словарь уровня 1 | «является», «играет ключевую роль», «уникальный», «открывает новые возможности», «в современном мире» |
| Канцелярит (1Б) | «осуществляется», «данный», «в рамках», «в целях», «посредством» — совет по стилю, не довод об авторстве |
| Кальки | «адресовать проблему», «это про», «на ежедневной основе», «имеет смысл», «в моменте» |
| Транслитерации и ИТ-жаргон | «бейзлайн», «пайплайн», «чекпоинт», «апрув», «фидбэк», «митигировать» — совет по стилю, не довод об авторстве |
| Синтаксис | «не просто X, а Y», цепочки родительного падежа, пассив без деятеля, навязчивые тройки |
| Авторитет и значимость | «исследования показывают», «эксперты считают», «знаменует новую эру», оценки без чисел |
| Соцсети | «И вот тут начинается самое интересное», «Сохраняйте, пригодится», «Встречайте:» |
| Типографика | тире-связки, дефис вместо тире, прямые и английские кавычки, десятичная точка, Title Case |
| Ритм | одинаковая длина предложений и абзацев, бедный словарь, одинаковые начала |
| Каркас абзаца | пояснение через двоеточие почти в каждом предложении, мораль в конце абзаца, «во-первых… в-третьих» в прозе — правила на суждение |
| Технические отпечатки | невидимые символы, подмена букв, [Вставьте источник], oaicite, utm_source=chatgpt.com |
| Редкие типографские символы | неразрывные и узкие пробелы, шпации, неразрывный дефис, знак минуса, стрелки: жёлтый светофор «ИИ или типография?», в оценку не идут |
Ограничения
- Приметы — это сигналы, а не доказательство авторства. Их выдают и люди, особенно в научном и канцелярском регистре. Не используйте детектор как единственное основание для решений об академической нечестности, найме или публикации.
- Как классификатор детектор слабый, и это видно по цифрам. На русской части тестового набора LLMTrace оценку «много примет» и выше получили 5,9 % из 21 417 человеческих текстов (у новостей 13 %) и 16,7 % из 14 064 сгенерированных. Больше половины сгенерированных текстов детектор счёл чистыми. Он показывает, что править в тексте, а не кто его написал.
- Модель
antiplagiat— приближение. Классификаторы «Антиплагиата» и «Думейта» закрыты. Веса по умолчанию подобраны вручную на небольших примерах, а не обучены на корпусе. Калибровка подстраивает веса под то, как система ведёт себя на ваших текстах, но точную цифру отчёта не гарантирует. - Отшлифованный научный текст детектор может не видеть совсем. На обзорной статье, где «Думейт» нашёл 38 % ИИ-текста,
antiplagiatи ModernBERT показали 0 %, а по фрагментам оценка детектора против подсветки отчёта дала ROC AUC 0,40, хуже случайной (docs/domate.md). Если есть отчёт с подсветкой, правьте по нему; без отчёта абзацы лучше выбирает слепой судья, но и он только ранжирует. - Морфология упрощена: основы со звёздочкой вместо полноценного морфологического анализатора. Редкие формы могут проскочить, омонимы могут дать ложное срабатывание.
- Регулярные выражения не видят смысла. Правила, которые требуют суждения (ложный деятель, бег на месте, выдуманный контраст), есть только в скилле, детектор их не ищет.
Разработка
uv sync --group dev --group trainuv run prek install --hook-type pre-commit --hook-type commit-msg --hook-type pre-pushuv run pytestuv run prek run --all-filesuv sync --group dev --group train ставит детектор, инструменты разработки (группа dev) и зависимости для обучения модели (группа train); без групп ставится только детектор, как у пользователя скилла. Хуки prek прогоняют ruff, ty, самопроверку документации детектором и синхронность версий. Тесты покрывают разбор текста, каждое правило детектора, корпус живых и шаблонных текстов шести жанров, CLI, скрипты выпуска и сами скиллы: шапки SKILL.md, ссылки, связь разделов каталога с типами находок детектора, примеры из каталога.
Поведение скилла на живом агенте проверяет uv run python evals/run.py: двенадцать случаев (защищённые цитаты, попытка внедрить инструкцию в текст, ловушка на выдуманные числа, режим только поиска и другие) с автоматической оценкой ответа. В CI этот прогон не входит.
Хуки prek перед коммитом проверяют гигиену файлов, секреты, формат, типы, невидимые символы, фрагменты собственных работ автора (если они лежат в ~/.config/aiw-ru/private) и сообщение коммита (на русском); перед отправкой запускают тесты. Правила участия — в CONTRIBUTING.md, история изменений — в CHANGELOG.md.
Выпуски
uv run python scripts/release.py patchgit push --follow-tagsСкрипт переносит раздел «Не выпущено» из CHANGELOG в новую версию, обновляет версию в pyproject.toml, манифестах, скиллах и CITATION.cff, делает коммит и тег. По тегу GitHub Actions публикует пакет на PyPI через доверенную публикацию (без токенов в секретах) и создаёт выпуск с архивом скиллов, контрольными суммами и заметками из CHANGELOG.
Как сослаться
Если проект пригодился в исследовании, данные для ссылки лежат в CITATION.cff; GitHub показывает их кнопкой «Cite this repository».
Благодарности
Огромное спасибо Конору Бронсдону за avoid-ai-writing. Без этого проекта русской версии не было бы. Оттуда взяты режимы работы, договор о правке, уровни серьёзности, трёхуровневый словарь, профили контекста и голоса, самоисключение для текстов о приметах и правило «никогда не добавляй». Отдельно спасибо за то, что исходный проект честно называет свои находки сигналами, а не доказательствами, и держит это правило во всех решениях.
Спасибо авторам и участникам, на чьи находки опирается исходный проект и, через него, этот: blader/humanizer, brandonwise/humanizer, Aboudjem/humanizer-skill, isatimur/de-slop, welttowelt/stop-slop-refined, LLM cliché highlighter Саймона Уиллисона и tropes.fyi.
Спасибо Илье Утову за humanizer-ru. Оттуда идеи сверки фактов в aiw-ru validate, проверки правки свежим агентом, теста на переносимость и трёх примет детектора: «почерк модели», обвязка ответа чата и оборванный текст. Код, словари и замеры здесь свои.
Русская часть многим обязана традиции борьбы с канцеляритом, которая старше нейросетей на полвека: Корнею Чуковскому, придумавшему само слово «канцелярит» в книге «Живой как жизнь», Норе Галь с её «Словом живым и мёртвым» и Максиму Ильяхову и Людмиле Сарычевой с книгой «Пиши, сокращай».
Лицензия
MIT. Copyright (c) 2026 Conor Bronsdon — исходный проект; Copyright (c) 2026 Ilya Lubenets — русская адаптация. Подробности о происхождении частей — в NOTICE.md.
This repo does not document an install step we could read. Check the README on GitHub.
Install with your agent
Paste this prompt into your agent. It reads this page and does the setup for you.
Read https://aiagentslisting.com/mcp/avoid-ai-writing-russian to learn what the "Avoid Ai Writing Russian" MCP server does and how to install it. Add it to my coding agent's MCP configuration as documented on that page, then confirm the server connects and list the tools it exposes.Agents can also browse this directory over MCP at https://aiagentslisting.com/api/mcp
This server doesn't publish a machine-readable tool manifest, and it doesn't expose a public endpoint we could ask. Connect the server locally to see what it exposes.
We could not run this server: it ships no npx package for our sandbox and no public endpoint. The four checks that need a live server are left out, and the grade tops out at B until one exists.
What's missing
- Installation methodRequiredThe README documents at least one way to install or connect.0/15
- Easy installA paste-ready client config (an mcpServers block) is documented.0/12
- Claimed by ownerThe maintainer proved ownership of this listing.0/4
All 5 checks (2 passed)
- Installation methodRequiredThe README documents at least one way to install or connect.0/15
- Has a READMERequiredThe repository ships documentation we could read.10/10
- Easy installA paste-ready client config (an mcpServers block) is documented.0/12
- Has a licenseThe repository declares a license.8/8
- Claimed by ownerThe maintainer proved ownership of this listing.0/4
- Verified liveNot checkableWe connected to the server and it answered a real MCP handshake.—
- Exposes toolsNot checkableThe server reports at least one tool, from its manifest or a live read.—
- Ships promptsNot checkableThe server exposes at least one prompt template.—
- Ships resourcesNot checkableThe server exposes at least one resource.—
Maintain this server? Claiming proves you own the listing and earns the last 4 points.
Claim this listingShow this grade in your README

Paste this line near the top of your repository's README. The badge always renders the current score.
[](https://aiagentslisting.com/mcp/avoid-ai-writing-russian)Alternatives to Avoid Ai Writing Russian
Nothing comparable is listed yet.
v2.7.0Release notesv2.6.0Release notesv2.5.2Release notesv2.5.1Release notesv2.5.0Release notesv2.4.0Release notesv2.3.0Release notesv2.2.1Release notesv2.2.0Release notesv2.1.0Release notesv2.0.0Release notesv2.0.0rc4Release notesv2.0.0rc3Release notesv2.0.0rc2Release notesv2.0.0rc1Release notesv1.0.0Release notesv0.3.0Release notesv0.2.0Release notes
Send this prompt to your agent to leave a review
Connect to the AI Agents Listing MCP server at https://aiagentslisting.com/api/mcp using the HTTP transport and complete the sign-in when it asks. Then call the submit_review tool for the listing "avoid-ai-writing-russian" with a rating from 1 to 5 and a short note on what worked and what did not.No reviews yet
Be the first to share your experience with this tool.
Subscribe to our newsletter
One email a week. New agents, MCP servers and skills, and what is actually getting traction.